Zaloguj się


 Wszystkie


 7 października 2026
 12

Problem, który Git rozwiązuje
Zacznijmy od sytuacji, którą zna każdy konstruktor. Projekt zasilacza laboratoryjnego jest gotowy w wersji, którą wysłano do wytwórcy płytek. Trzy tygodnie później okazuje się, że trzeba zmienić wartość jednego rezystora w pętli sprzężenia i poprawić rozkład masy pod przetwornicą. Zmiany wchodzą, płytka jedzie do produkcji ponownie – a po dwóch miesiącach ktoś pyta, która dokładnie wersja schematu odpowiada egzemplarzom z pierwszej partii, bo klient zgłasza usterkę występującą tylko w niej.
Odpowiedź na to pytanie da się uzyskać na dwa sposoby. Pierwszy polega na przeszukaniu katalogów nazwanych datami i domyślaniu się, który z nich odpowiada pierwszej partii. Drugi polega na wpisaniu jednego polecenia. Różnicę między tymi dwoma sposobami pracy pokazuje rysunek 1.
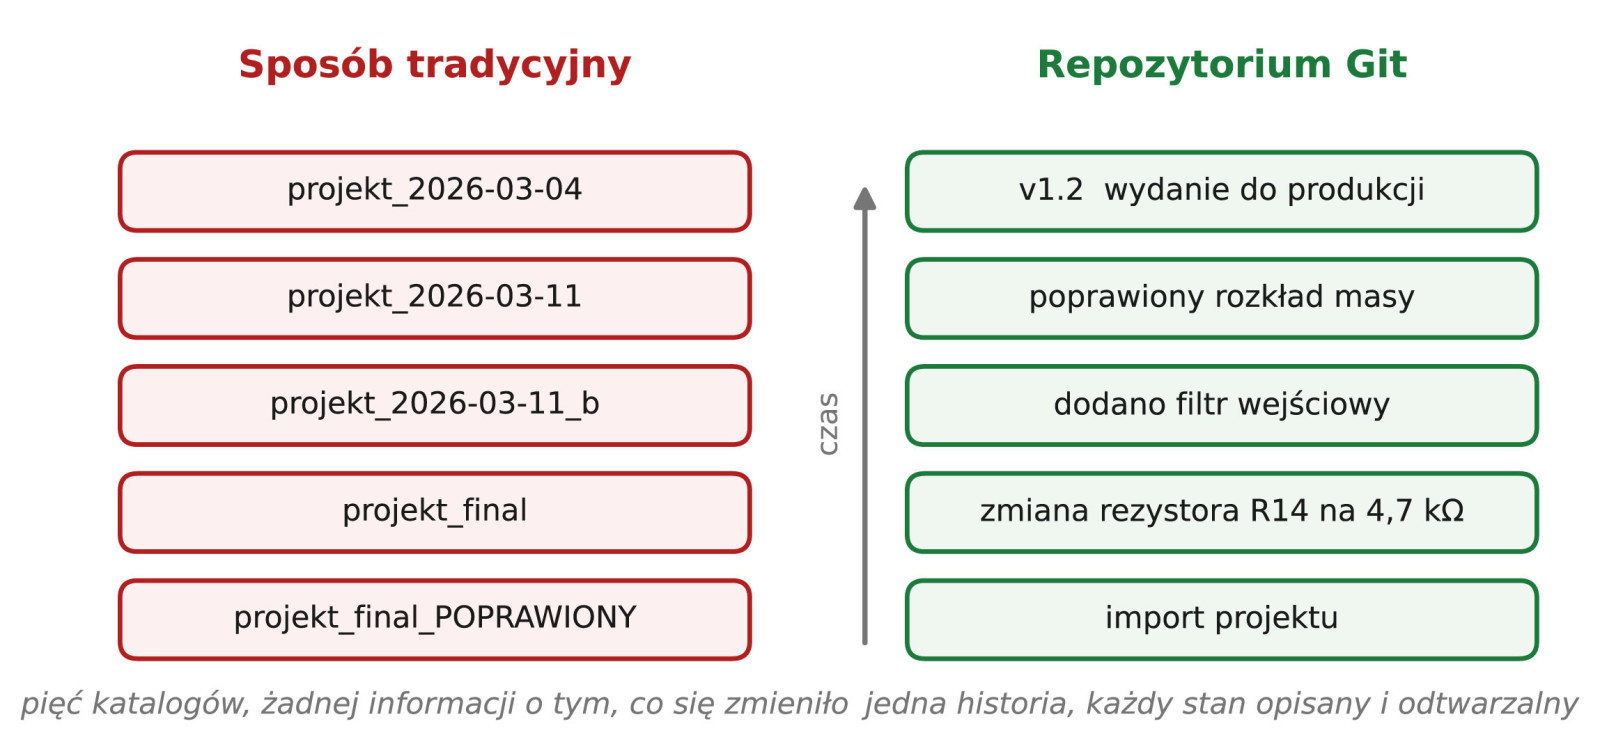
W kolumnie po lewej stronie rysunku 1 znajduje się pięć katalogów, których nazwy mówią wyłącznie o tym, kiedy je utworzono. Nie mówią, co się w nich zmieniło ani dlaczego. W kolumnie po prawej stronie jest jedna historia, w której każdy zapisany stan ma opis wprowadzonej zmiany, datę, nazwisko autora i własny, niepowtarzalny identyfikator. To jest cała idea kontroli wersji.
Czym Git jest, a czym nie jest
Git jest programem, który przechowuje historię zmian projektu. Powstał w kwietniu 2005 roku – jego pierwotnym autorem jest Linus Torvalds, twórca jądra Linuksa, a od 2005 roku rozwojem kieruje Junio Hamano. Git jest oprogramowaniem otwartym i bezpłatnym, dostępnym dla systemów Windows, macOS i Linux. Kolejne wydania ukazują się mniej więcej co kwartał, dlatego nie podajemy tu numeru bieżącej wersji – zawsze aktualny znajduje się na stronie projektu.
Trzy nieporozumienia, które warto usunąć od razu. Po pierwsze, Git to nie jest GitHub. Git jest programem działającym na komputerze konstruktora; GitHub jest jednym z wielu serwisów, w których można przechowywać kopię repozytorium i które opisujemy w drugiej części poradnika. Po drugie, Git nie wymaga połączenia z internetem – cała historia projektu leży na dysku lokalnym i wszystkie podstawowe operacje wykonują się bez sieci. Po trzecie, Git nie jest kopią zapasową. Kopia zapasowa chroni przed awarią nośnika; Git chroni przed utratą informacji o tym, co i dlaczego zostało zmienione. To dwie różne rzeczy i obie są potrzebne.
Zapisywanie stanu projektu w Gicie przebiega dwuetapowo, co pokazuje rysunek 2. Najpierw wybiera się, które zmiany mają wejść do zapisu – to polecenie git add, a miejsce, w którym zmiany czekają, nosi nazwę poczekalni albo indeksu. Dopiero potem wykonuje się właściwy zapis poleceniem git commit.
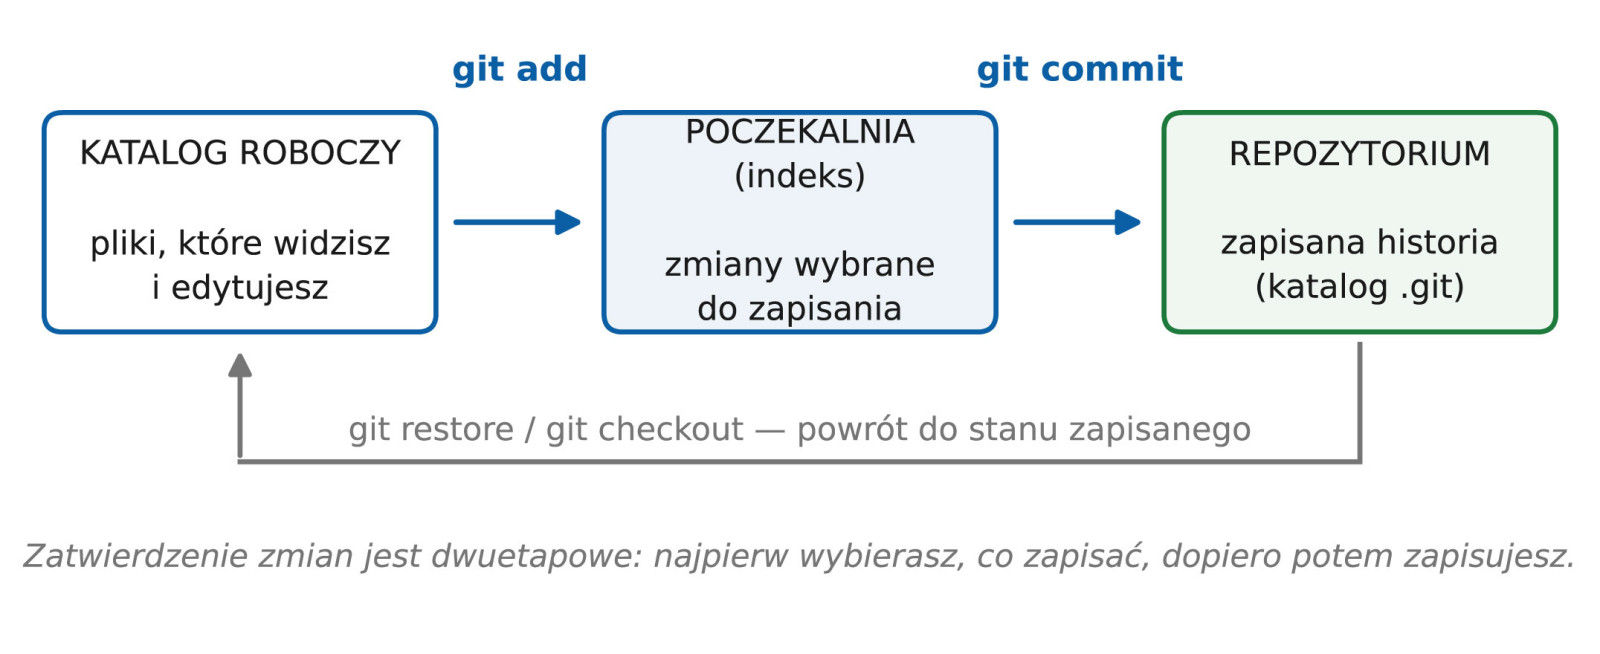
Ten dwuetapowy przebieg wydaje się początkowo zbędnym utrudnieniem, a jest jedną z najużyteczniejszych cech Gita. Pozwala z sesji pracy, w której poprawiono jednocześnie schemat, rozkład ścieżek i literówkę w instrukcji, zrobić trzy osobne, opisane zapisy zamiast jednego zapisu o treści „poprawki”.
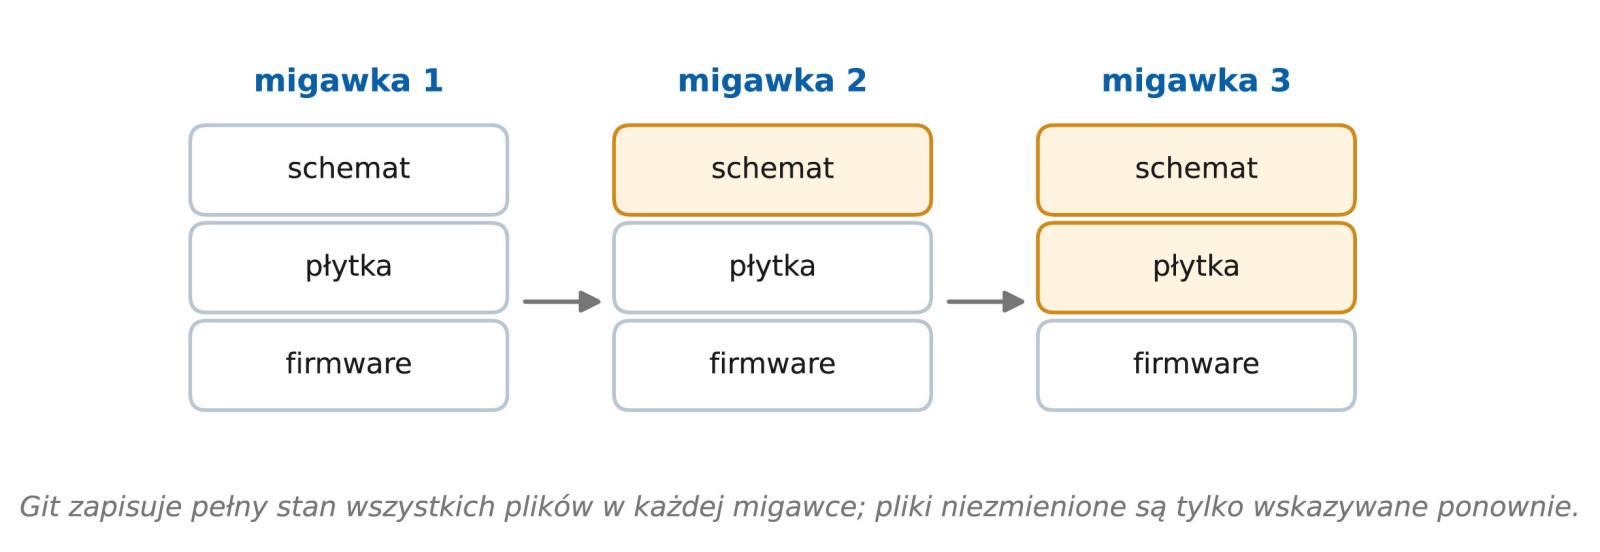
Warto też wiedzieć, jak Git przechowuje dane, bo różni się to od starszych systemów kontroli wersji. Git nie zapisuje kolejnych różnic względem poprzedniej wersji – zapisuje pełne migawki stanu wszystkich plików, a pliki, które się nie zmieniły, są w kolejnej migawce tylko wskazywane ponownie. Pokazuje to rysunek 3. Praktyczny skutek jest taki, że przywrócenie dowolnego stanu z przeszłości jest operacją natychmiastową, niezależnie od tego, ile zapisów dzieli go od chwili obecnej.
Instalacja i jednorazowe ustawienia
Instalator pobiera się ze strony projektu (rysunek 4). W systemie Windows instalator zawiera zarówno sam program, jak i powłokę Git Bash oraz podstawową nakładkę graficzną; ustawienia domyślne są dla początkującego użytkownika właściwe i nie ma powodu ich zmieniać. W systemach Linux Git instaluje się z repozytorium dystrybucji, w macOS – wraz z narzędziami wiersza poleceń albo z menedżera pakietów.

Po instalacji wykonuje się dwa polecenia, które ustawiają dane podpisywane pod każdym zapisem. Robi się to raz na stanowisku:
Pierwsze repozytorium
Repozytorium zakłada się w katalogu istniejącego projektu – Git nie wymaga przenoszenia plików ani zmiany ich układu. Cała historia trafia do ukrytego katalogu .git wewnątrz katalogu projektu. Przebieg zakładania repozytorium i zapisania pierwszego stanu pokazuje rysunek 5.
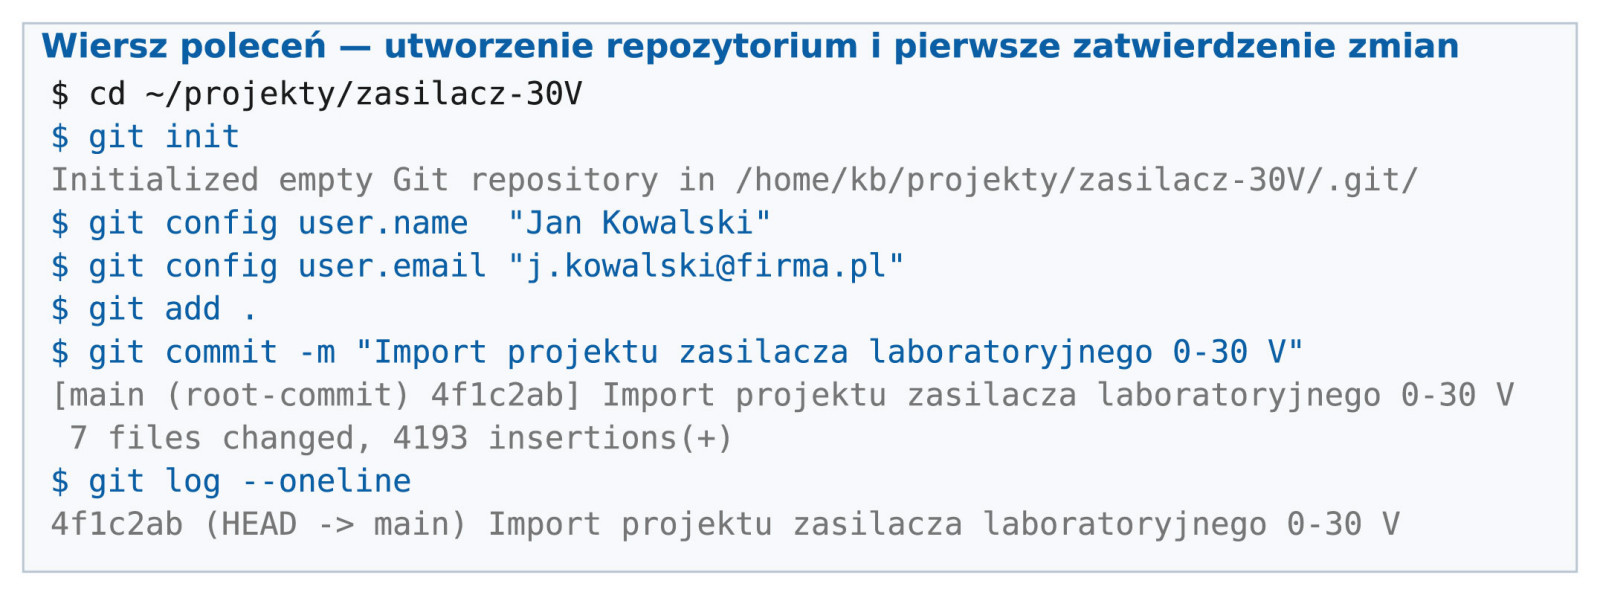
Warto zwrócić uwagę na ciąg 4f1c2ab w wyniku ostatniego polecenia z rysunku 5. Jest to skrócony identyfikator zapisu – suma kontrolna wyliczona z całej zawartości projektu w tym momencie oraz z identyfikatora zapisu poprzedniego. Ma to dwie konsekwencje.
Po pierwsze, identyfikator jednoznacznie wskazuje jeden konkretny stan projektu i nie da się go pomylić z żadnym innym. Po drugie, ponieważ każdy zapis zawiera identyfikator swojego poprzednika, niezauważalna zmiana czegokolwiek w historii jest niemożliwa – zmiana jednego znaku w starym pliku zmienia identyfikatory wszystkich późniejszych zapisów.
O opisach zapisów: nie warto ich lekceważyć. Opis „poprawki” po pół roku nie znaczy nic. Opis „zmiana R14 na 4,7 kΩ – kompensacja przeregulowania przy skoku obciążenia” pozwala odtworzyć całe rozumowanie bez otwierania schematu. Zasada jest prosta: opis ma odpowiadać na pytanie „dlaczego”, bo na pytanie „co” Git odpowie sam.

 NAPISZ DO AUTORA

 Facebook
 Twitter
 Linkedin



 Kup teraz